战略调研 · 2026-09-17
晶泰科技 AI 平台调研
与华大研究院路径建议
从「卖能力」到「持资产」——一家 AI4S 公司的护城河解剖,以及我们该学什么、该做什么
资料源:晶泰官方 2026 中报 / 2025 年报 / 发布通稿 · 会议现场 PPT 13 页 · 第三方统计与文献
护城河诊断收入结构解剖分级框架对照
能力互补权益设计短肽路径
01 / 结论先行
五句话看懂这次调研
如果只看一页,看这一页。
01
它不是 AI 制药算法公司,是物理世界的执行层
300+ 自动化实验工站、200+ 领域模型、多智能体编排,加上累计 50 万条真实实验记录——其中约 80% 是公开文献里拿不到的失败负样本。
02
它用了和我们同一套自动驾驶类比,但把刻度挪了一格
晶泰自称实现的 L4「Domain-Specific Autonomous」≈ 我们的 L3 黑灯实验室。它没有 L0 那一档,且 L3 栏列的其实是合成检测服务,分级图有营销痕迹。
03
真正的护城河只有一条
随时间单调增长的私有湿实验数据(尤其失败样本),由自建自动化实验室的工程隐性知识所派生。模型、Agent、多云平台、合作名单——都是可复制的红海。
04
但护城河是「化学的」,不是「AI4S 的」
机器人、反应数据、合成模型全都不迁移到生命科学。它往生物铺的三块——虚拟细胞、器官芯片、类器官——全是投资/孵化,没有一个是自研。
05
收入结构里,最赚钱的那一段护城河最薄
2025 年首次盈利靠一笔 5,100 万美元授权首付款;2026 上半年这笔钱不在,立刻由盈转亏 2.249 亿元。用设备和服务赚现金流,用管线授权赚利润,用平台讲故事——三件事的护城河硬度是倒过来的。
02 / 背景
晶泰是谁:基本盘与三次跃迁
港股上市主体为晶泰控股(XtalPi Holdings,2228.HK),境内主体深圳晶泰科技有限公司。检索未见与之并列的独立「晶泰生物」实体。
| 成立 / 团队 | 2015 年,三位麻省理工学院物理学家创立(温书豪、马健等) |
| 上市 | 2024 年 6 月港交所主板,18C 规则下首家特专科技上市企业 |
| 定位 | 基于量子物理第一性原理计算 + AI + 高性能云计算 + 机器人自动化的创新研发平台 |
| 2025 全年 | 营收 8.026 亿元(+201.2%);年内利润 1.346 亿元、经调整利润 2.582 亿元;AI4S 领域首家盈利的港股上市公司;年末现金 70.686 亿元 |
| 2026 上半年 | 营收 3.936 亿元(同比 −23.9%,剔除去年同期一次性授权首付款后 +73.8%);净亏损 2.249 亿元;研发费用同比 +66.0%;现金 86.712 亿元 |
| 分部收入 | 药物发现解决方案 2.001 亿元 · AI4S 智慧解决方案 1.935 亿元(+136.4%) |
| 客户 | 累计覆盖全球前 20 大药企中的 17 家;2025 年创收客户数 +62% |
| 口径提醒 | 以上均为公司自述,未见第三方独立验证 |
三次战略跃迁——顺序很重要
2015 — 2019
计算
成立即做量子物理 + AI 计算(纯干实验)。代表作:帮辉瑞确认 Paxlovid 优势晶型,只用 6 周。
2019 — 2022
自建实验室
2019 年起在深圳河套自研自动化实验室;2022 年上海张江总部落成、实验室首次公开亮相(当时逾 3,000 平米,客户已含青煜医药、海正药业、溪砾科技)。
2023 — 2025
资产化
从「接项目」转向「持管线」:DoveTree(总盘子 59.9 亿美元)、礼来(3.45 亿美元)、晶科能源等授权与平台协议相继落地。
2026 —
平台化
7 月 29 日发布 XtalPi Science 平台与 Genius Agents 智能体矩阵,联合 26 家伙伴发起「科学智能开放生态联盟」,截至发布当天中午近 200 家机构提交试用申请。
关键:不是「先有设备,后有数据」
真实链条是 计算能力 → 拿到算法单 → 发现拿不到实验数据 → 自建实验室去产数据 → 数据反过来喂模型 → 模型批量产出可专利分子 → 资产化授权。设备不是起点,是它为了解决「模型缺燃料」而自建的工具;把它变成产品卖出去是顺带的商业化。
03 / 技术架构
平台架构:四层技术引擎
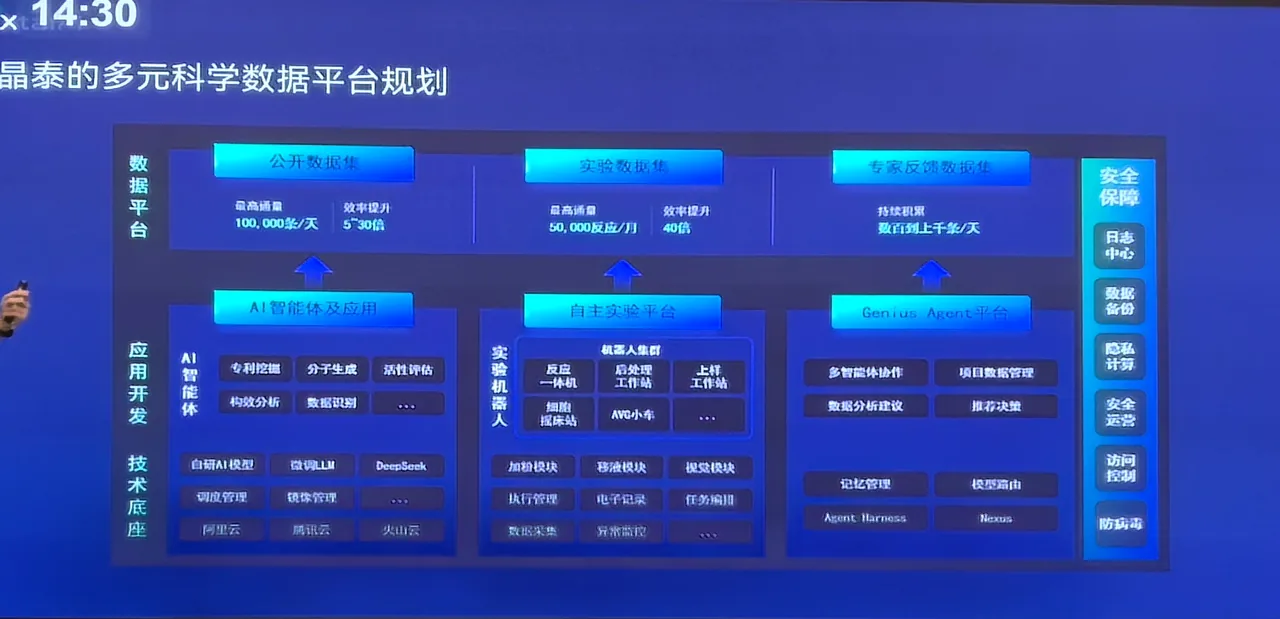
中报明确表述的架构:Genius Agent(智能中枢)· Scientific AI(科学智能)· Physical AI(物理智能)· Data Moat(高质量数据底座)。
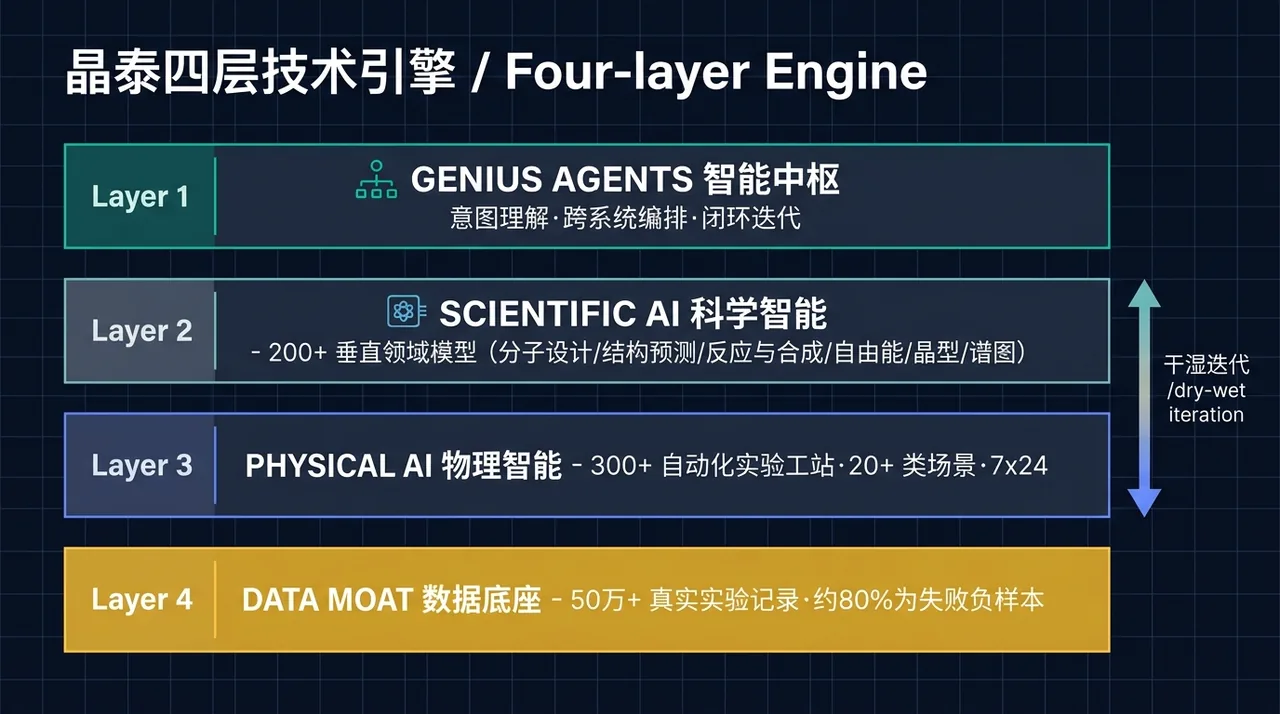 图 1 · 四层技术引擎(本页自制示意图)。干实验与湿实验之间靠智能中枢做「干湿迭代」,数据底座在最底层持续供给。
Genius Agents 智能中枢
多智能体体系,统一编排科学模型、专业工具、研发流程与数据资源;把经典的 DMTA(设计—制造—测试—分析)循环重构成「上百类研发意图」;目标设定与路线决策等关键节点保留科学家最终判断权;专家隐性知识固化为可复用 Skills。
Scientific AI 科学智能
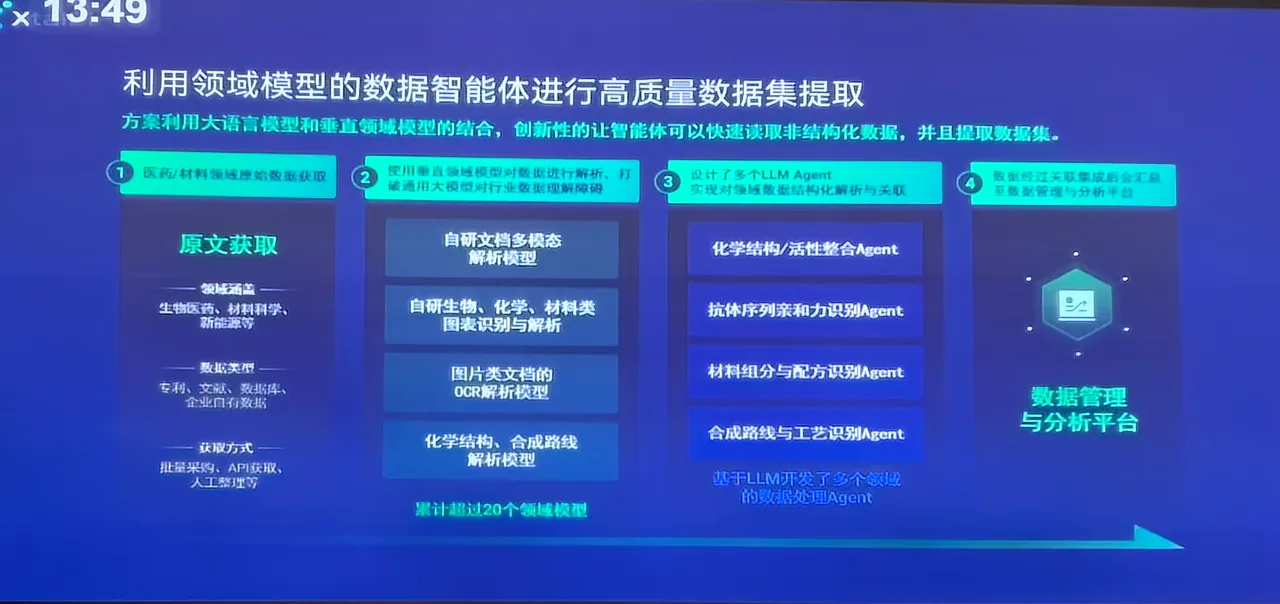
200+ 垂直领域 AI 模型,覆盖分子设计与生成、结构预测、活性与成药性、化学反应与合成(20+ 类反应预测)、自由能与量子化学、固态与晶型、生物大分子、谱图与数据解析。
Physical AI 物理智能
全球部署逾 300 台自动化工站,覆盖 20 余类研发场景,7×24 执行实验与数据采集。难点不在机械臂——在固体粉末加样、粘稠体系、无水无氧、后处理这类非标工序。
Data Moat 数据底座
服务逾 100 个新药及新材料发现项目;每月产出 5 万余条反应产率数据与 30 万条过程数据;累计逾 50 万条真实实验记录,约 80% 为失败负样本。
配套的两层「中间件」
Nexus 能力中台
把 200+ 项科学算法统一封装(统一封装 · 安全可控 · 即插即用),形成 AI Agent ↔ NEXUS ↔ 科学算法能力三层结构。卖点是资产沉淀、一次封装全品复用、越用越强、跨行业通用。
多云智算引擎
面向 AI 负载(训练/推理/工作流)与高性能批量计算优化的云原生算力平台;纳管本地 Slurm/PBS 集群与 AWS、GCP、腾讯云、阿里云;支持任务多队列、优先级亲和性、多云调度分发与细粒度账单。
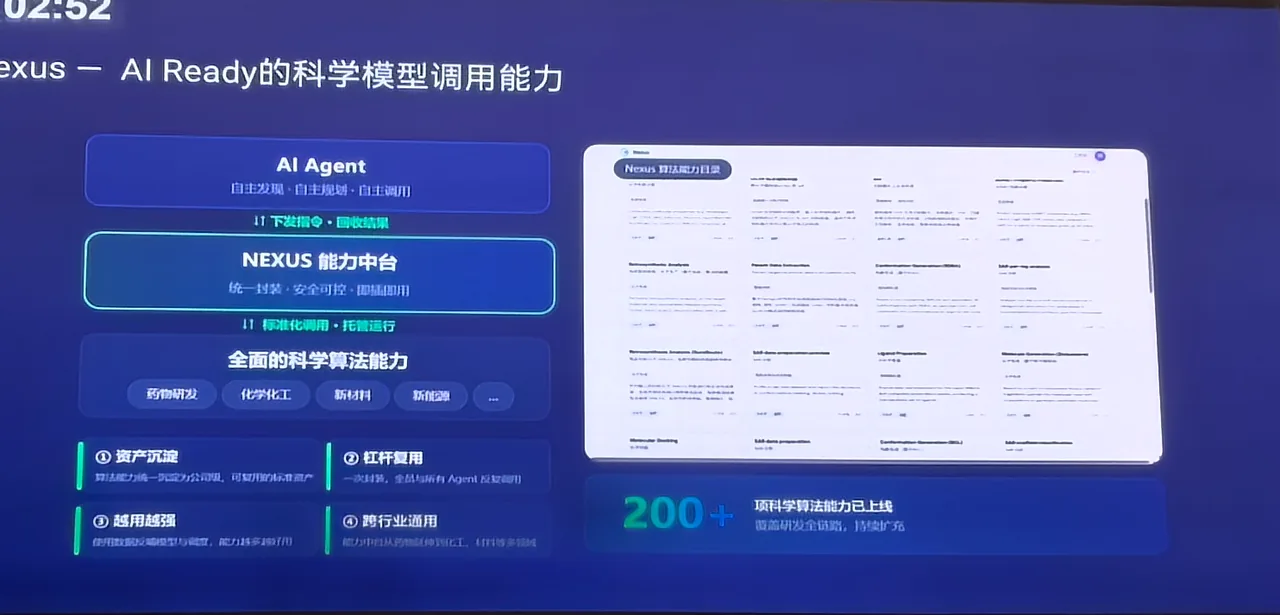 晶泰原图 · Nexus 能力中台。来源:晶泰 2026 AI4S 发布会现场 PPT 照片。
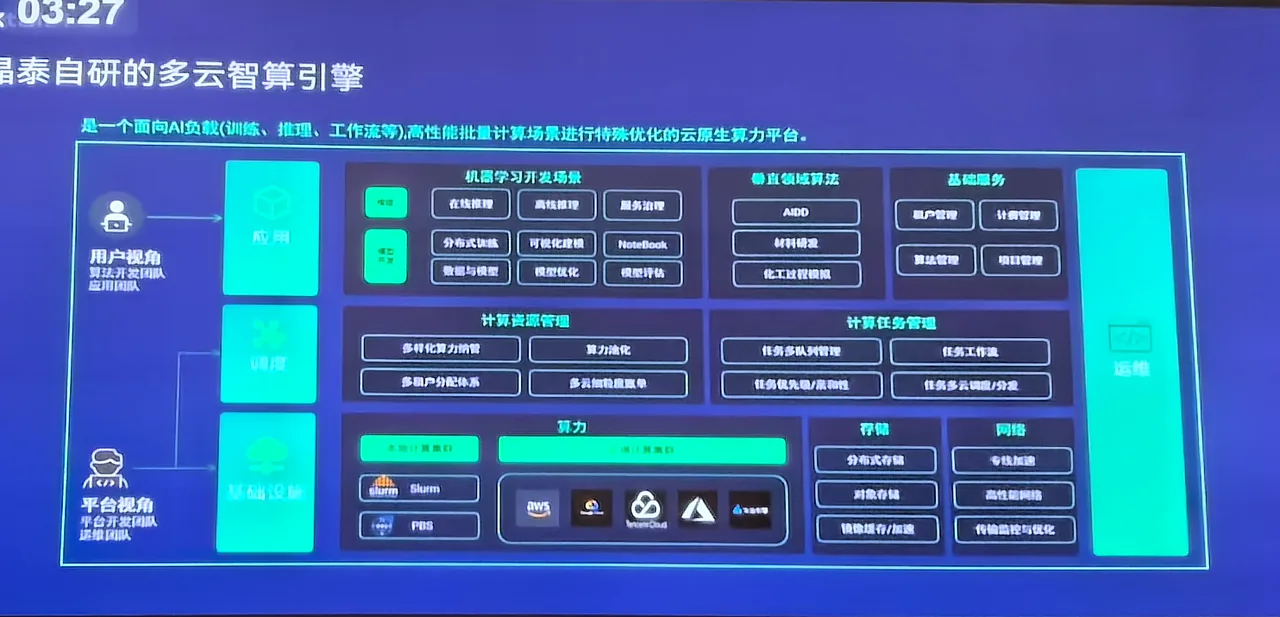 晶泰原图 · 多云智算引擎。同样体现了它在算力层的统一纳管思路。
04 / 产品矩阵
智能体矩阵与产品线
已具名的 7 个子智能体,加上软件、硬件与新模态平台,构成它的完整产品面。
| 子智能体 | 定位 |
|---|
| Cetus Agent | 小分子药物 |
| MolAgent | 药化 SAR 专家助手 |
| Ailux Agent | 抗体 / 蛋白药 |
| X-Buddy Agent | 靶点研究 AI 基础平台 |
| AiFChem Agent | 化学品找货比价 · 需求到采购清单 |
| HTE Agent | 高通量反应条件优化 |
| 库合成 Agent Team | 项目管理 · 实验开设编排 |
软件产品
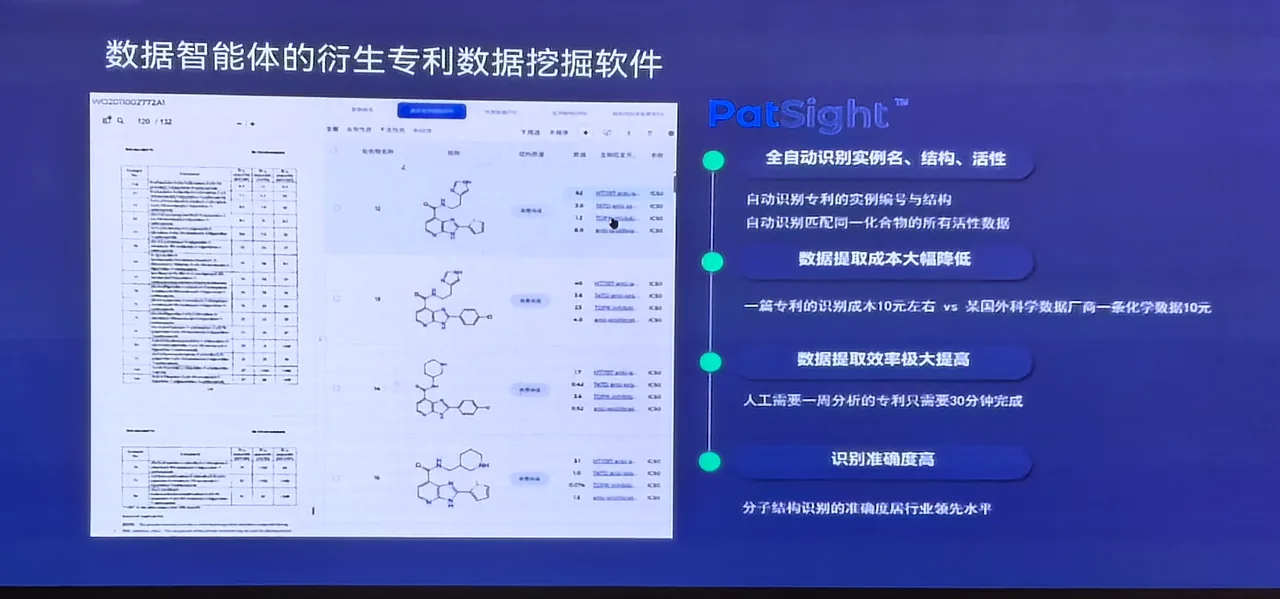
- PatSight —— 药物专利挖掘
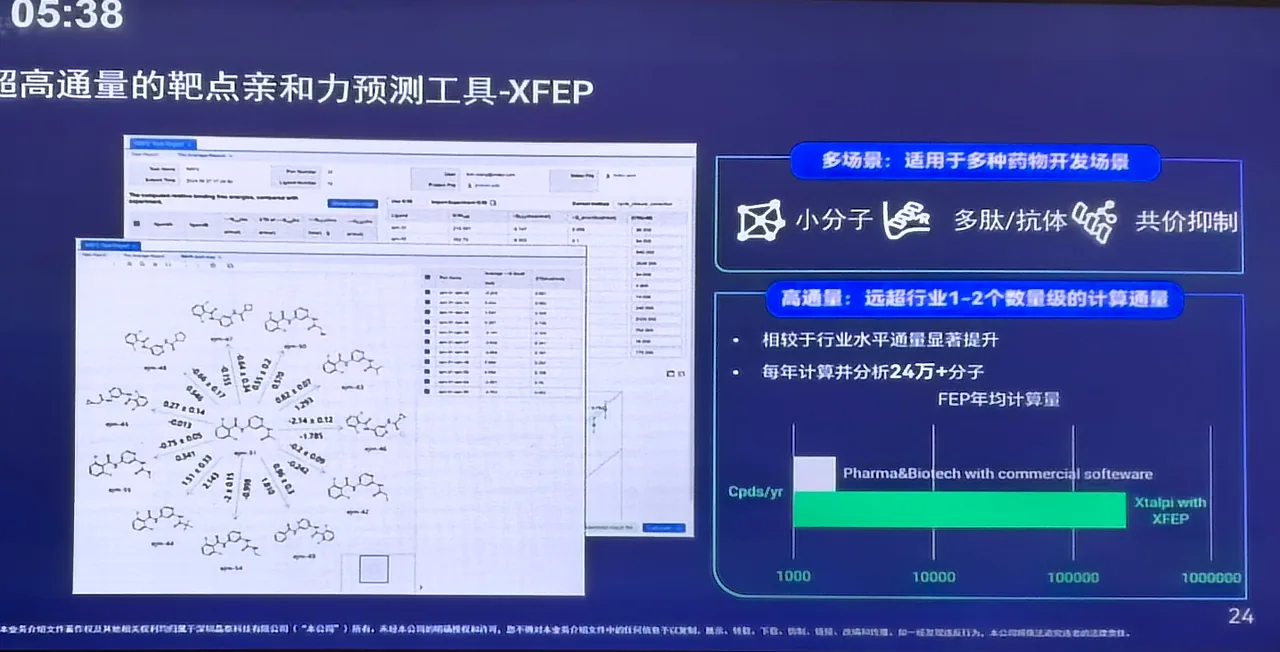
- XFEP —— 自由能微扰亲和力预测
- XMolGen —— 多功能分子设计
硬件产品
- XmartChem 智能合成工作站(已复制推广至 13 家客户)
- 智能电解液工作站
- ChemPlus 桌面型固体加样仪
- NeoDispenser 智能微量粉末分装
新模态平台
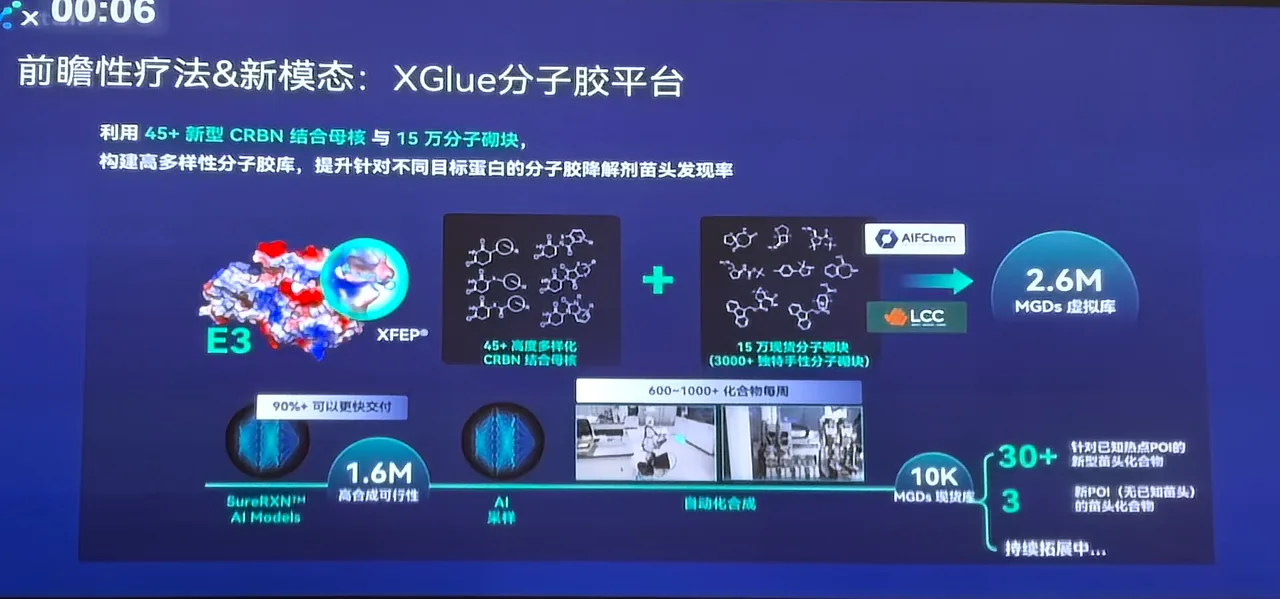
- XGlue —— 分子胶
- PepiX —— 多肽 / 口服环肽
- Kodexia —— 小核酸 siRNA
- Ailux —— 大分子抗体
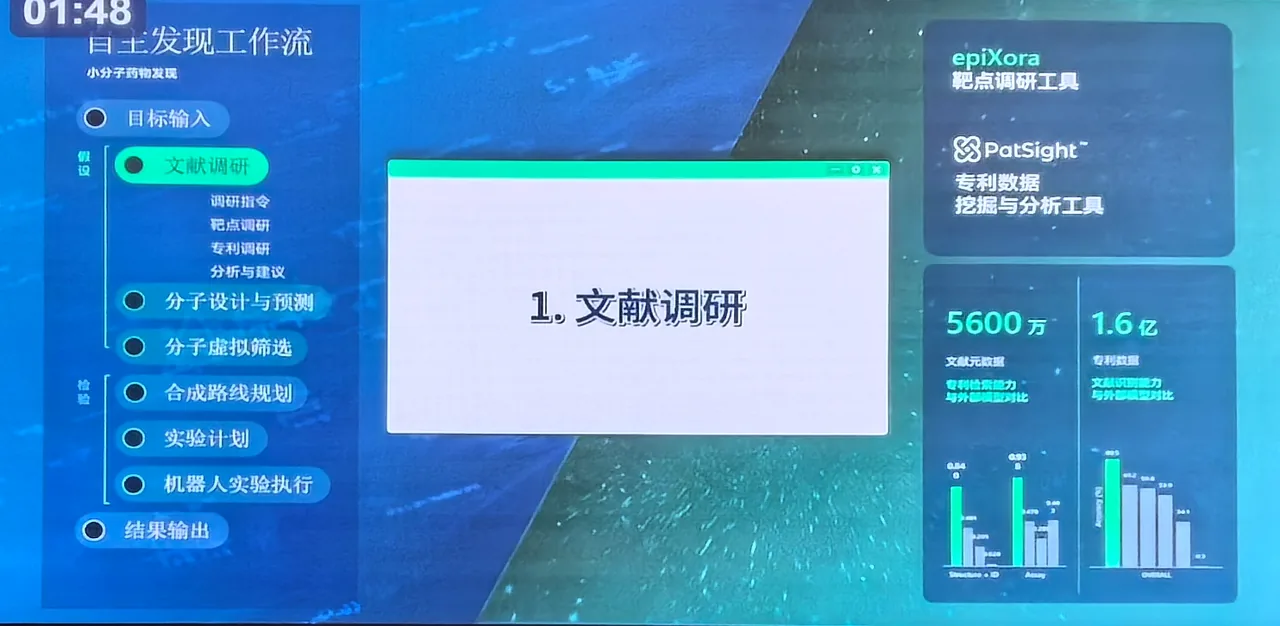
 晶泰原图 · 自主发现工作流(小分子药物发现)。从目标输入到结果输出,假设端(文献调研 / 分子设计与预测 / 虚拟筛选)与检验端(合成路线规划 / 实验计划 / 机器人执行)分列。
 晶泰原图 · XGlue 分子胶平台。45+ 新型 CRBN 结合母核 × 15 万分子砌块,构建 260 万分子胶虚拟库;自动化合成 600–1000+ 化合物/周。
06 / 框架对照
它用了我们的分级框架,把刻度挪了一格
晶泰在中报里「率先提出」把科学自主发现分为 L1–L5,并自称已在多个研发场景实现端到端 L4 自主发现能力(自述)。两套框架的映射关系如下。
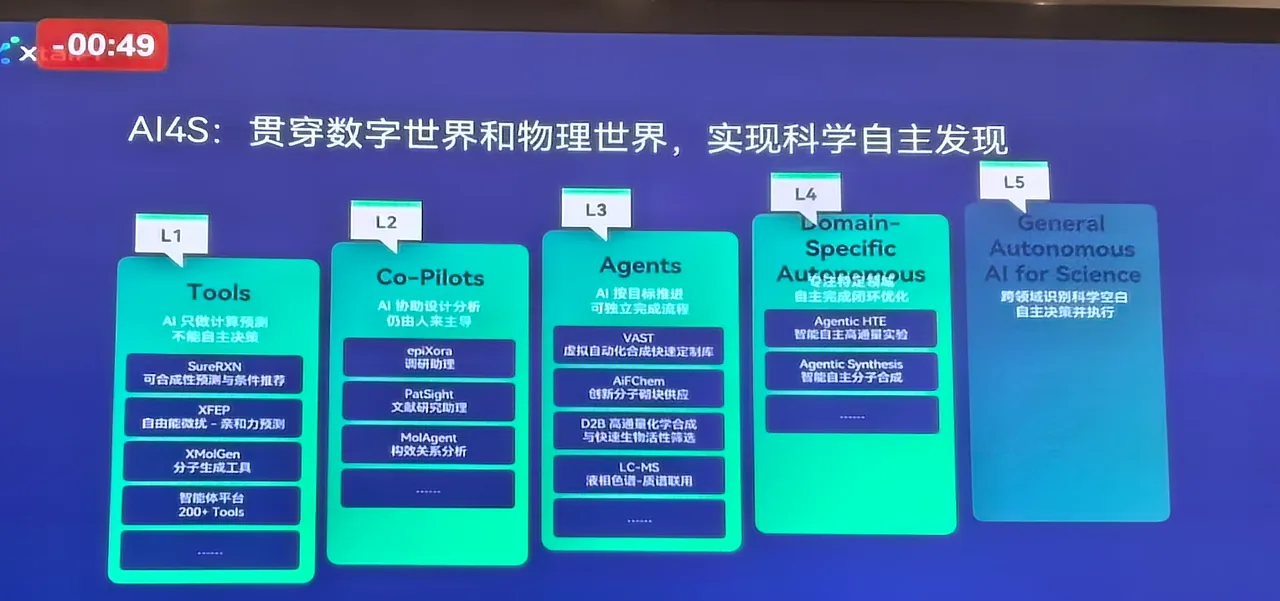 晶泰原图 · AI4S:贯穿数字世界和物理世界,实现科学自主发现。L1 Tools(AI 只做计算预测)→ L2 Co-Pilots(AI 协助设计分析)→ L3 Agents(AI 按目标推进)→ L4 Domain-Specific Autonomous(专注特定领域自主闭环)→ L5 General Autonomous AI for Science。
| 晶泰分级 | 对应本研究院框架 | 说明 |
|---|
| L1 Tools | L0 / L1 | SureRXN、XFEP、XMolGen 等计算预测工具 |
| L2 Co-Pilots | L1 辅助科研发现 | epiXora 调研助理、PatSight、MolAgent |
| L3 Agents | L2 自动科研发现工作流 | 它这一栏列的却是 VAST 虚拟化合物库、AiFChem 砌块供应、D2B、LC-MS —— 属合成检测服务,并非自主智能体 |
| L4 Domain-Specific Autonomous | L3 人机协同科学发现(黑灯实验室) | Agentic HTE、Agentic Synthesis —— 这是它自述已实现的层级 |
| L5 General Autonomous | L4 AI 驱动科学领域演进 | 目前无对应产品 |
三点提醒
① 晶泰的 L4 ≈ 我们的 L3,两者不能混着引用——否则外界会把它当成比我们高一档。
② 它没有 L0(信息提供与建议)那一档,分级图是产品导向而非能力导向。
③ 它的 L3 一栏放的是产品能力而非自主智能体,这一页偏营销口径。
08 / 护城河诊断 · 上
先打掉四个「假护城河」
这四样最容易被误认为壁垒,实际都可复制。
① 200+ 模型与单点算法
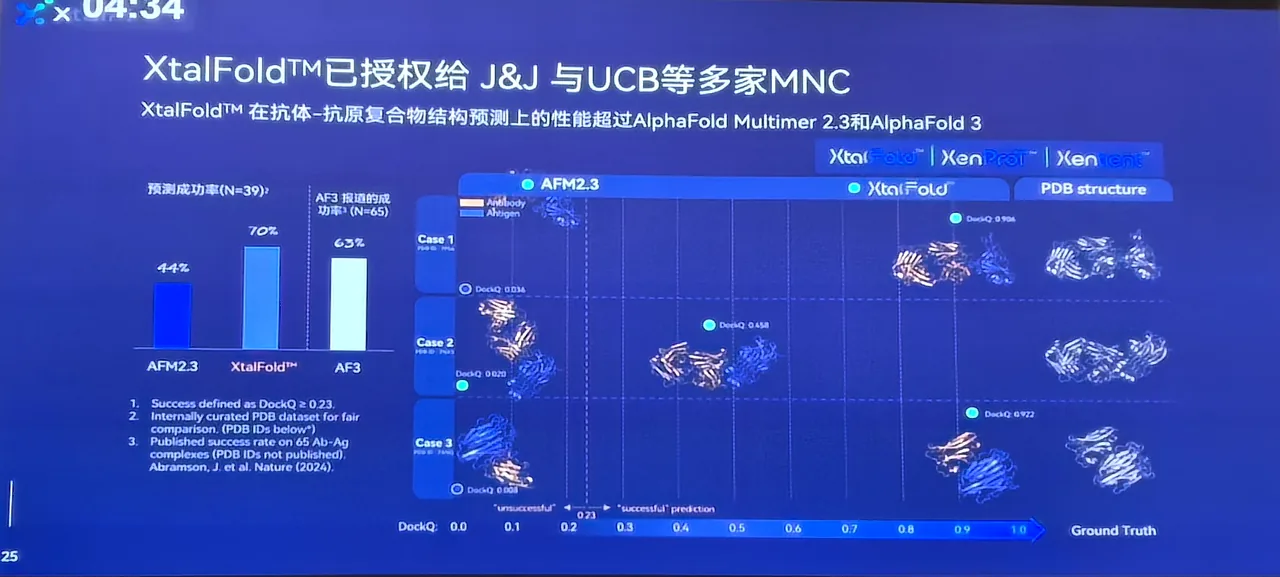
单点模型学术界与竞品都有对标。XtalFold 与 AF3 的差距是个位数到十几个百分点,且两边评测集不同。模型会过期,不是护城河。
② LLM 智能体编排
2024 年以来最大的红海。Genius Agents 的 7 个 agent 换个名字,谁都能搭一套。
③ 多云智算引擎 / Nexus 中台
通用工程能力。阿里云、AWS 现成卖,自建只省成本。封装得再好,也不阻止别人封装自己的。
④ 大药企合作名单
大多数是「交付一套工作站」的一锤子买卖:罗氏百万级、赫力昂百万级、巴斯夫一台配方工作站。名字好看,不构成黏性。
09 / 护城河诊断 · 下
真正的护城河,按硬度排
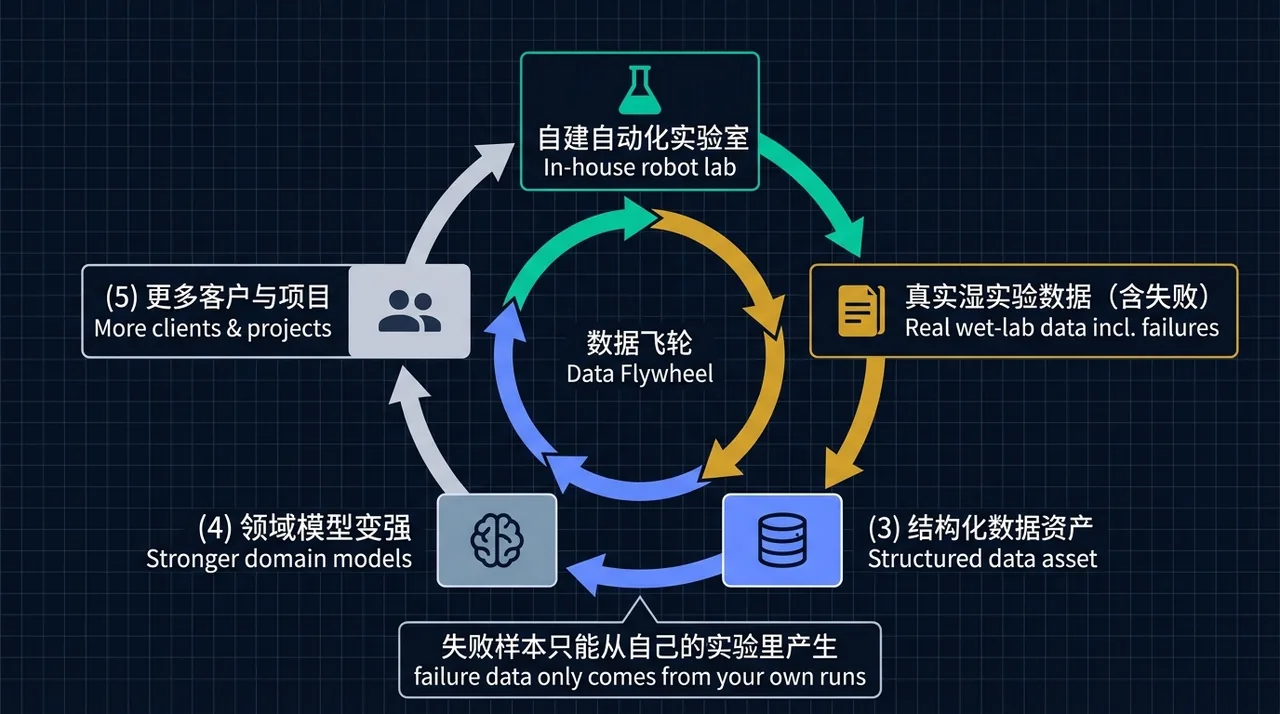 图 2 · 失败数据飞轮(本页自制示意图)。这是它唯一一个随时间单调增长的壁垒。追赶者必须完整重跑这一圈。
硬度 1
自建自动化实验室的工程隐性知识
难点根本不在机械臂。化学实验的脏活在固体粉末加样、粘稠体系、无水无氧、后处理过滤——非标工序,没有通用解。它为「灵动勺」粉末处理、NeoDispenser 微量分装专门写了视觉算法、粉末属性数据库和粉末基座模型。这类 know-how 只能一单一单磨出来,花钱买不到,也没法逆向工程。时间常数:5 年、300+ 台工站、20 余类场景。
硬度 2
50 万条真实实验记录,约 80% 为失败负样本
为什么不可复制——公开数据库里只有正样本:没有哪家药企会把合成失败的路线发论文。失败数据只能从自己跑的真实实验里产。
自举循环:这是它最硬的壁垒,也是最难追的
要失败数据 → 得先有自建实验室 → 实验室要养得起 → 得有客户 → 客户要模型准 → 模型准要靠失败数据。晶泰把这个圈跑通了,追赶者必须从零跑一遍,且追赶期它还在涨。
硬度 3
干湿闭环的链条完整性(结构性)
别家要么大脑强手脚弱,要么手脚强大脑弱。晶泰是少数同时握有 第一性原理计算 → 领域模型 → 自研机器人 → 自建实验室 的全栈。单点都不算顶尖,但闭环比单点值钱,因为它决定迭代速度。
硬度 4
客户端切换成本(潜在,未验证)
Science Token 计量 + 私有化部署 + 数据格式/实验流程/模型接口绑定 ≈ ARM 模式。但近 200 家只是试用申请,转化率公司没给指引。
对失败样本这一条要打一折
「80%」只是负样本占比,不是「有信息量的失败」的占比。失败也分种类——操作手抖、试剂过期跟路线选得对不对没半点关系,这类喂进模型就是噪声。公司从未披露这个拆分。
10 / 关键判断
但护城河是「化学的」,不是「AI4S 的」
这是本次调研最重要的一个判断:它用跨领域叙事去要估值,但实打实的墙只有化学那一段。
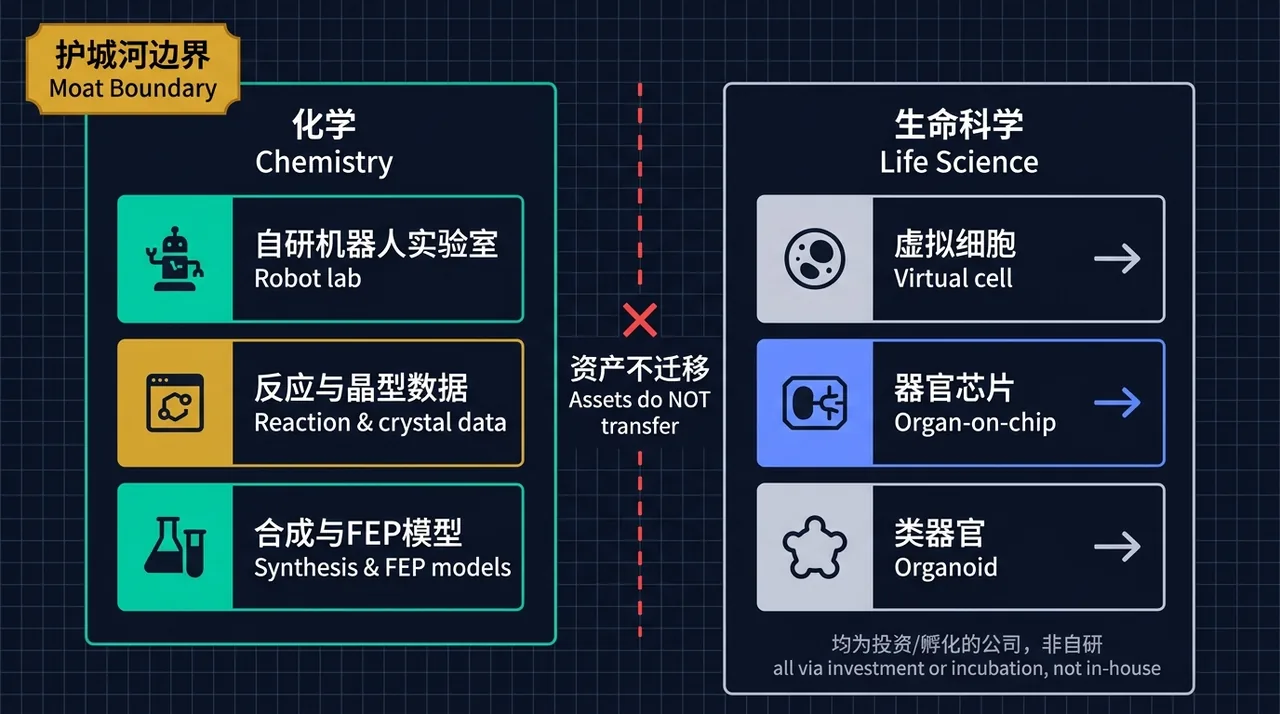 图 3 · 护城河边界(本页自制示意图)。三类核心资产——物理资产(化学机器人)、数据资产(反应产率/晶型/合成路线)、模型资产(逆合成/FEP)——全都不迁移到生命科学。
证据就在它自己身上
它往生物铺的三块——虚拟细胞(孵化企业无界进化)、器官芯片(孵化企业耀速科技)、类器官(与孵化企业希格生科合作)——全是投资 / 孵化,没有一个是自研。这说明它自己清楚物理护城河不跨界。
还有一个错位值得盯
赚钱的是护城河薄的那一半。2026 上半年增长主要来自 AI4S 智慧解决方案(+136.4%),而厚护城河那半(数据与平台订阅)还没形成收入。平台化对它是双刃——开放调用意味着把模型摆给客户看,靠「数据不外放、只卖模型调用」的结构维持;一旦客户自己攒够数据就松了。
11 / 商业解剖 · 上
收入结构:谁在赚钱
| 期间 | 总营收 | 药物发现解决方案 | AI4S 智慧解决方案 |
|---|
| 2025 全年 | 8.026 亿 | 5.379 亿(+418.9%)· 占 67% | 2.647 亿(+62.6%)· 占 33% |
| 2026 上半年 | 3.936 亿 | 2.001 亿 · 占 51% | 1.935 亿(+136.4%)· 占 49% |
按稳定性从低到高重排
- ① 一次性管线授权 / BD(历史上最大,也最不稳):2025 年 8 月 5 日 DoveTree 首付款 5,100 万美元到账并确认收入,公司明确说这笔「对报告期收益作出重大贡献」——2025 上半年的 5.171 亿营收里它是绝对主力,也直接把半年做成盈利。今年同期没这笔,营收掉到 3.936 亿、转亏。
- ② 研发服务费(平台合作服务项目,CRO 性质):稳,但薄。
- ③ 自动化设备 / 本地化部署:增长最快的现金流来源,单笔多在百万到千万级。性质上是一锤子买卖。
- ④ 智能服务:VAST 虚拟化合物库、创新分子砌块、高通量自主合成。2026 上半年新签订单高速增长,VAST 拿到 2 万多个分子的订单。
- ⑤ 平台订阅(Science Token):目前 ≈ 0。近 200 家是试用申请,没收入。
结论
它的收入曲线现在由 BD 交易的节奏决定,既不由设备决定,也不由平台决定。往后还要更波动——按公司公告,DoveTree 还有 4,900 万美元固定付款待收,另有 58.9 亿美元潜在里程碑(后者按监管/商业节点分期,实质是期权)。
修正一个容易犯的错
不能简单说「主要收入来自卖设备」。设备(AI4S 智能机器人实验室)只是 AI4S 板块里的一个子项,而公司没有披露设备与服务的拆分,只说两块都高增长。所以卖设备占总营收是不到四分之一的量级,具体数只有他们财务部知道。
12 / 商业解剖 · 中
授权收入的本质:药厂到底在买什么
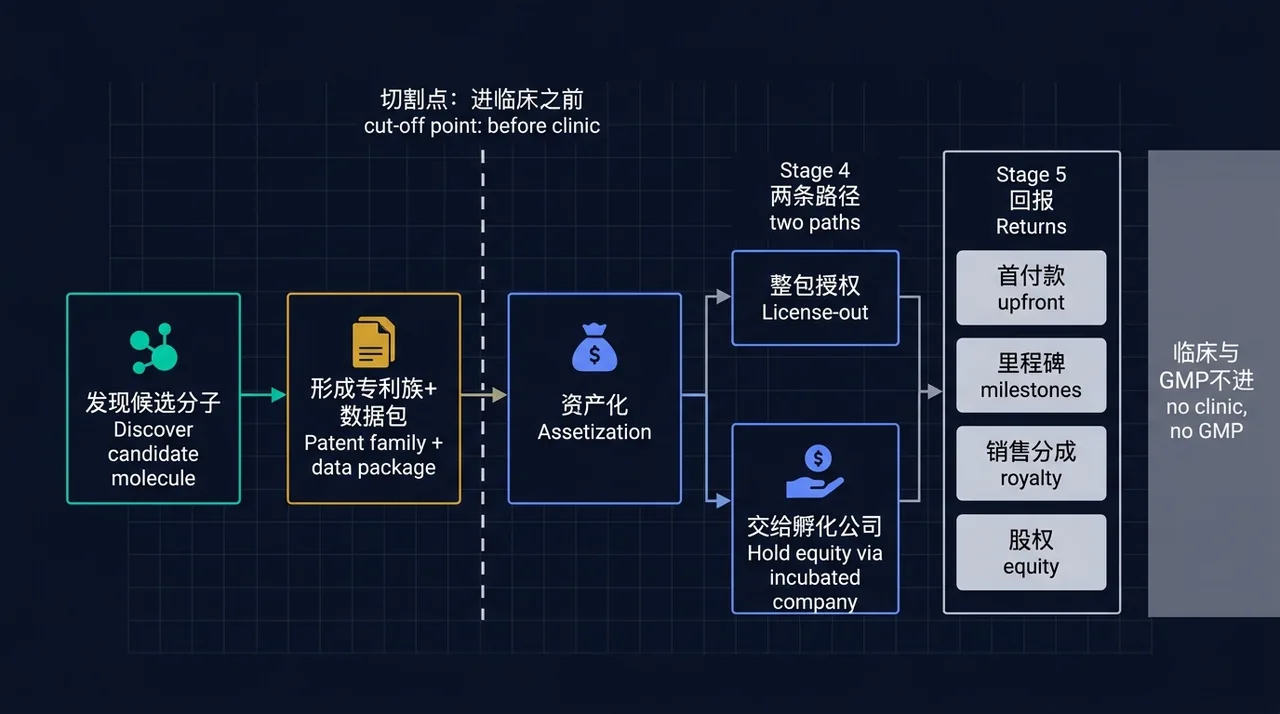 图 4 · 资产化路径(本页自制示意图)。切割点卡在「进临床之前」——临床的钱和风险转移给买方或孵化公司的投资人。
它是资产交易,不是卖软件
把自己发现的候选分子 + 专利族 + 数据包整体转让,换首付款 + 里程碑 + 销售分成。DoveTree 那笔公告写得很实:「5,100 万美元首付款所涉管线的相关专利已全部转让至 DoveTree」,DoveTree 拿全球独家开发和商业化权利。做这项收入的前提不是「有能力」,是持有可转让的 IP 实体。
DoveTree 不是药厂
它是 Gregory Verdine 设立的资产孵化公司(NewCo),名字取自中国珙桐。Verdine 出的是靶点判断和生物学洞见(29 岁任哈佛教授、参与创立十余家生物医药企业、主导研发 3 款 FDA 批准上市药);晶泰出的是工业化研发执行。第三方分析人士称之为「美国 IP + 中国效率」的 NewCo 模型。
59.9 亿美元这个数字要打折
固定付款只有 1 亿美元(5,100 万 + 4,900 万),其余 58.9 亿是「潜在里程碑」,与研发/注册/销售节点挂钩,另加产品净销售额个位数百分点分成。临床前资产绝大多数走不到上市——里程碑是期权估值,不是应收账款。这笔的真相是:一次性实收 1 亿美元,买下这批专利。
行业定价参照:这个价码不稀奇
- 2025 年中国创新药对外授权总额 1,356.55 亿美元、157 笔交易,首付款合计超 70 亿美元。
- 2026 年 Q1 又破 600 亿美元,平均首付款 1.84 亿美元(创历史新高)。
- 对标:翰森制药把一个临床前口服小分子 GLP-1 授权给默沙东,首付款 1.12 亿美元、总额超 20 亿美元。一个临床前资产就是这个价。
药厂买的五样,按权重排
① 能进临床的资产
分子结构 + 专利族 + 体内外数据。这是唯一可交割、唯一值钱的东西。药厂不会为「平台」付首付款,只会为「资产」付首付款。
② 时间
专利悬崖 + 上市窗口,MNC 内部早期发现产能不够,必须外采。
③ 拿不到的能力
分子胶、口服环肽、小核酸这类新模态,大药企内部做不快。且必须有专利新颖性——是已知化合物就一文不值。
④ 风险转移
那笔 4 亿美元的 GPCR 交易,公告写的是合作方「承担所有早期研发费用」。药厂买的是期权,不是承诺。
⑤ 交付确定性 —— 最容易被忽略,也最重要
药厂不怕贵,怕的是「约定了时间交不出化合物」。晶泰敢承诺节奏(多肽项目靶点确定后 2 个月出 hit、siRNA 启动 7 个月拿到非人灵长类药效、HTE 迭代从 3–4 周压到 6 天)。它的干湿闭环真正的商业价值不是「AI 多强」,而是让资产能被按期交割。
13 / 商业解剖 · 下
谁在做 IND:三类分工
这是它资产切割策略最直白的体现——绝大部分 IND 不是它自己申报的。
A · 自己申报(极少)
全资子公司 Ailux 三条自免管线 ALX001 / ALX002 / ALX005,首批三个 IND 定在 2027 年;自研 TRK/RET 双靶点已完成美国 Pre-IND 递交,预计 2026 下半年报中美 IND。
B · 孵化 / 赋能公司申报(主体)
希格生科(SIGX1094 已获中美 IND 批件;SIGX2649 已获 FDA IND 批件)、溪砾科技(RTX-117 中美双报双批)、默达生物、智擎生技、莱芒生物、剂泰科技。申办方是那些公司,不是晶泰。晶泰拿的是赋能 + 股权 + 里程碑与长期经济权益。
C · 授权出去的买方申报
DoveTree(专利已过户)、礼来、辉瑞、罗氏。后续开发与申报由买方承担。
为什么它不自己做
申报 IND 和做临床要的基建它没有:GLP 毒理、CMC / GMP 生产、临床运营团队、药物警戒体系。它那 300 台工站是化学合成自动化,不是 GMP 产线。所以资产切割点卡得很精确:做到「能进临床之前」就交割。两条路——整包卖给买方(DoveTree 式,一次性拿首付款),或交给孵化公司去申报、自己留股权和里程碑(希格生科式)——都规避了临床的钱和风险。
但这个局面正在变,这点最值得盯
Ailux 就是它为「自己持管线」专门搭的载体——独立 biotech 架构、自招 CSO(前阿斯利康呼吸免疫高级副总裁 Maria Belvisi)、自建大分子管线、首批 IND 定 2027。逻辑很直白:持临床资产的估值远高于卖临床前资产。代价也很直白:临床烧钱比临床前高一个量级。Ailux 能不能撑起来,是它这个故事的下一个验证点。
一处要提醒
中报那句「自研管线及赋能管线中已有 3 条进入临床阶段」是合并口径,不拆分。公开信息里无法确定这 3 条里有几条是晶泰自己当申办方的——要问清这一点,得直接查临床登记平台的申办方一栏。
14 / 落到我们身上
能力对照:我们与它的墙不重叠
这是它对我们最大的价值——不是「值得学的对象」,而是「结构互补的对象」。
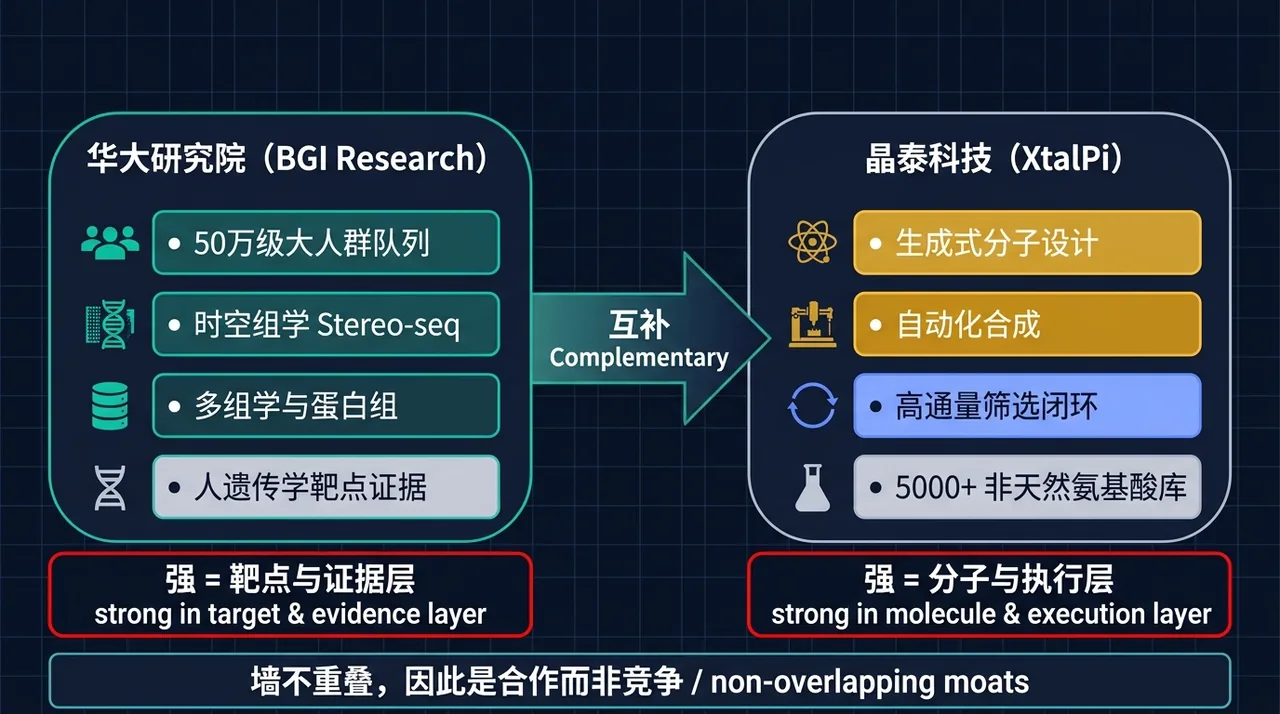 图 5 · 能力互补(本页自制示意图)。华大强在靶点与证据层,晶泰强在分子与执行层,两家的护城河不重叠。
我们强在「靶点与证据层」
- CKB 大人群队列(51.2 万余基线 + 三轮随访)——人遗传学靶点证据
- 时空组学 Stereo-seq
- 多组学与蛋白组学
- 五大数据产出计划:STOC · HGP2 · EBP · 10BC · 100KPM
它强在「分子与执行层」
- 生成式分子与多肽设计(HELM-DIFF 等)
- 自动化合成与机器人实验产能
- 高通量筛选闭环(万亿级肽库)
- 5,000+ 私有非天然氨基酸库
一句话
我们有队列但它没有;它有化学自动化但我们没有。互补而不覆盖,这是合作的理想结构,也是「权益设计」最自然的落点。
这条路径已经有科学依据
有遗传学证据支持的药物机制,成功概率是无遗传学支持的 2.6 倍。
—— Minikel et al., Nature 2024, doi:10.1038/s41586-024-07316-0
而且这篇论文自己指出了一个更关键的细节:这个相对优势随「对因果基因的置信度」提高而提高,与效应量大小、次等位基因频率、发现年份基本无关。
结论:价值不在「找到关联」,在把因果做扎实。谁先把「因果置信度」这一维做上去,谁的靶点清单就值钱——这正是队列 + 深度多组学 + 时空组织定位 + 蛋白组方向性验证能做的事。
15 / 我们该学什么
四条内核:可迁移的是「权益设计」,不是技术
内核 1
从「服务商思维」换成「资产方思维」
这是最要紧的一条。我们长期是按项目接活、按服务计费;晶泰的转折点恰恰是停止「接项目」,改成「输出能力换权利」。能力输出之前先问:我能换回什么权利,而不是我该收多少钱。
内核 2
把能力做成可复用的中台,并且建权益台账
晶泰的孵化矩阵能跑,靠的是能力标准化封装(Nexus 式)+ 统一的权益登记。我们现在说得清「做了哪些项目」,但说不清「提供了什么能力、换回了什么权利」。没有台账,就没有议价。
内核 3
换回来的东西要设计,不要默认
股权 / 分成 / 优先合作权 / 数据权益 / 样本权益 / 联合 IP —— 这些可以组合定价,也可以不谈而默认归零。差别就在有没有人负责谈。
内核 4
边界划在「不做重资产」这一侧
晶泰不碰 GMP 与临床,我们也不该碰。这条它划对了——它的资产切割点精确卡在「进临床之前」。
但有一件事不能学
晶泰这套「赋能换股权」的孵化模式能转,一半靠设计,一半靠融资周期。它成立的前提是那些孵化公司能独立融到钱——这依赖退出通道(港股 18A、科创板第五套、license-out 给 MNC)。2025 年中国创新药出海授权冲到 1,356 亿美元,才撑起「临床前资产也值钱」的预期。
一旦 BD 出海退潮、18A 破发、VC 不再为临床前资产付溢价,这个模式立刻卡住——孵化公司融不到钱,晶泰就得自己掏钱,那就变回自持管线了。所以它本质是资本市场的杠杆,不只是商业模式的设计。
16 / 我们该做什么
四条行动:从靶点清单开始
行动 1 · 最优先
先定义「经人群遗传学验证的干预靶点清单」该长什么样
把证据分级标准、所需数据维度、交付形态定下来。这件事的价值是双份的:对内统一各团队的筛选口径,对外它才是可谈价的资产。没有这个标准,我们产出的是「论文里的关联」;有了它,产出的是「可交割的靶点资产」。
行动 2
补上「湿实验 → 结构化 → 回流模型」这条管道
这是我们与晶泰差距的真正所在。它的 50 万条是机器产出、带过程参数、可追溯的;我们的大量数据还停在「人工记录 + 分散存储」。建设重点不是算力也不是模型,而是数据回流与失败样本归档制度——这是唯一能长出时间壁垒的地方。
行动 3
短肽这条线,先做「皮肤时空组学 → 外用短肽」
外用对稳定性、口服吸收的要求低,是最容易先落地的场景。相比之下,CKB → 系统性给药这条线,递送和稳定性是硬约束——方向(聚焦抑制剂靶点 + 编码区 pLoF)是对的,但必须同步把给药路径和适应症场景定下来,否则会做出「靶点很好但递送不了」的分子。
行动 4
分子端优先「换能力」,而不是「自建」
我们在靶点端领先,在分子端(合成、展示筛选、活性验证的湿实验闭环)是缺的。晶泰的长板恰好在这里。与其投钱自建一条化学自动化线,不如用靶点权益或联合开发权益去换对方的合成与筛选能力——更快、更省,且不占用研究院的科研编制。
已有基础可以直接接上
短肽线我们已经有一批可用的技术件:mRNA 展示(库容可达 10¹³,远超噬菌体 10⁹–10¹¹)、RaPID 先例(化学环化一步拿到 nM 级刚性环肽,顺带解决抗蛋白酶降解)、OPO 偶联平台(已发表,NC 2026)、纳米孔读出。缺的是三件事串起来之后的自动化产能与高通量筛选节拍。
17 / 边界与风险
不该做什么,以及要提前想的坑
✕ 不追临床与 GMP 重资产
晶泰把边界划在「进临床之前」,我们同样不该往那个方向投。这不是能力问题,是资产性质问题。
✕ 不按服务工时给能力定价
把本可资产化的东西卖成工时,是最大的价值浪费。这是最需要改的一条习惯。
⚠️ 关联交易与利益冲突——最容易踩的坑,事先指出
研究院的资源给到自己参股的公司,怎么定价、怎么披露、怎么证明不是「内部人受益」?晶泰是纯商业公司,没人问这个问题;我们一定会被问。这个坑要么事先设计好通道(成果转化平台 / 产业基金 / 联合实验室协议),要么就别碰股权,只换数据与知识产权权益。
三个外部约束,需要在方案里写进去
- 短肽成药性三关:稳定性(蛋白酶降解)、递送(口服/透膜/透脑)、规模化合成成本。晶泰现在攻的恰好是后两关(口服环肽、脑递送),说明这是行业公认卡点,不是我们独有的困难。
- 模式依赖资本周期:孵化换股权的前提是孵化公司能独立融资;BD 出海退潮即卡住。
- 数据主权边界必须写清:同一套能力若同时卖调用、卖私有部署、又自持管线,客户一定会问「你会不会拿我的数据训模型、再自己拿去申请专利跟我竞争」。晶泰的解法是「数据不出域 + 私有化部署」——这条边界是它平台化能不能成的死穴,我们若走合作路线,同样要先想清楚。
18 / 下一步
三步走
短期 · 2 周
产出「经人群验证的干预靶点清单」的证据分级标准与样本样板
含:证据分级定义(pLoF / MR / 共定位 / 蛋白组方向性)、所需数据维度、单条靶点的交付字段、首批示范案例(已知靶点复现 + 1–2 个未知靶点)。
中期 · 1–2 月
皮肤外用短肽的场景技术路线 + 分子端合作方案
含:靶点筛选结果 → 短肽设计 → 展示筛选 → 活性验证的完整路线图;以及「自建 vs 换能力」两条路径的对比(时间 / 投入 / 风险 / 权益结构)。
长期 · 持续
建立研究院「能力—权益台账」
把每一项对外能力输出与换回的权利登记造册:提供什么、给谁、换回什么、期限多久、谁负责跟踪。这是从「服务商」转向「资产方」的基础设施。
一句话收尾
晶泰真正教会我们的不是「AI 怎么做科研」,而是 能力输出的时候,先想权利,不要先想价格。它用五年时间把「造数据」这件事内部化,然后把这个过程变成了可交割的资产。我们手上握着的是更稀缺的一头——人群与证据。